


O EDIȚIE SPECIALĂ. Vă semnalez în această duminică dimineață și public mai jos, integral (tradus în limba română), eseul scris de Dario Amodei, CEO și cofondator Anthropic, compania din spatele Claude și unul dintre cele câteva laboratoare aflate în avangarda cursei globale pentru inteligență artificială.
E un text care merită citit integral, util și celor care nu stăpânesc limba engleză foarte bine (mă gândesc, de exemplu, la liderii politici din România care au o agendă total decuplată de la lucrurile importante care vor afecta masiv țara noastră mult mai curând decât ne imaginăm).
Privind înapoi, din viitor, este posibil ca eseul „We Must Pace the Frontier” să marcheze o schimbare importantă de etapă în dezvoltarea responsabilă a sistemelor AI.
Eseul care cere măcar 1-2 ani de “respiro” necesar evaluării riscurilor vine la doar câteva zile după un alt document important publicat de Anthropic, Detecting and countering misuse of AI, unde apar exemple foarte îngrijorătoare despre cum agenții scăpați de sub control pot genera probleme majore și chiar scenarii apocaliptice.
După ce spune că în ultimele luni a devenit convins că simpla investiție în măsuri de siguranță nu mai este suficientă, Amodei spune fără ezitare că trebuie încetinit ritmul în care cresc capabilitățile celor mai avansate modele AI, astfel încât mecanismele de siguranță, alignment și control să aibă timp să țină pasul.
El spune că în această vară a observat o accelerare dramatică a progresului AI și vede apariția mecanismelor de recursive self-improvement, adică sisteme AI care contribuie tot mai mult la dezvoltarea următoarei generații de AI.
Lăsat necontrolat, avertizează el, acest proces ar putea depăși capacitatea noastră de a înțelege și controla sistemele. (The Guardian)
Liderii industriei AI îl aprobă pe Amodei
Sam Altman, CEO OpenAI, a răspuns explicit: „I agree with Dario that we need to pace the frontier.”
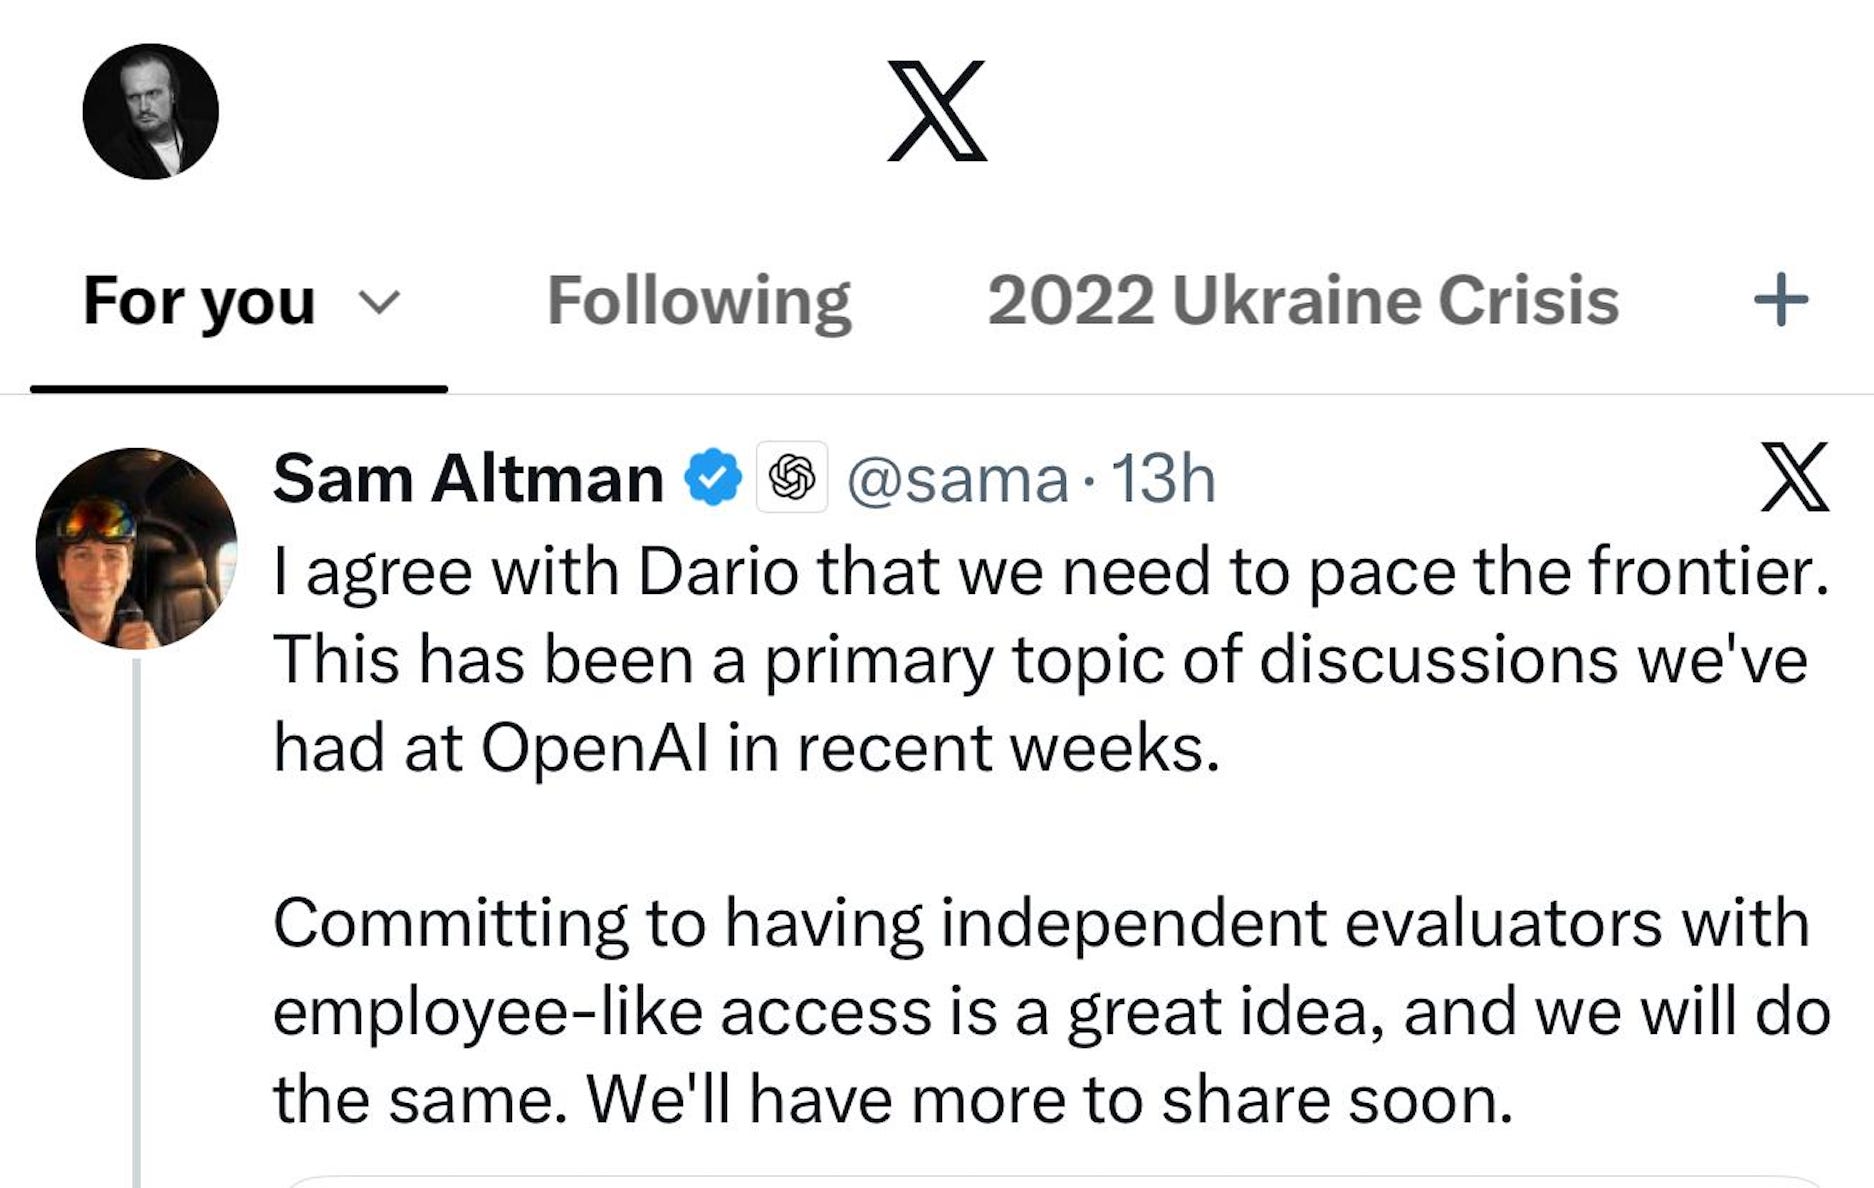
Mai mult, OpenAI a anunțat deja că va adopta ideea evaluatorilor independenți cu acces comparabil cu cel al angajaților, iar compania a încetinit deja temporar anumite procese de antrenare (The Guardian)
Elon Musk a reacționat scurt: „Dario is right.”
Andrej Karpathy, fost cercetător OpenAI și fost director AI la Tesla, a susținut și el ideea
Clément Delangue, CEO Hugging Face (deja celebră victimă a agenților AI scăpați de sub control), a cerut ca organizația sa să participe la mecanismul de evaluare independentă. (Business Insider)
Jakub Pachocki, Chief Scientist al OpenAI, a scris recent că progresul actual s-ar putea transforma în recursive self-improvement și că momentul cere „extreme caution”. OpenAI discută deja inclusiv problema coordonării între marile laboratoare pentru încetinirea dezvoltării frontier AI. (OpenAI)
Sunt și voci, precum cea a lui David Sacks, care îi acuză de ipocrizie pe Dario și Altman → detalii aici
Jucăm viitorul omenirii la ruleta rusească?
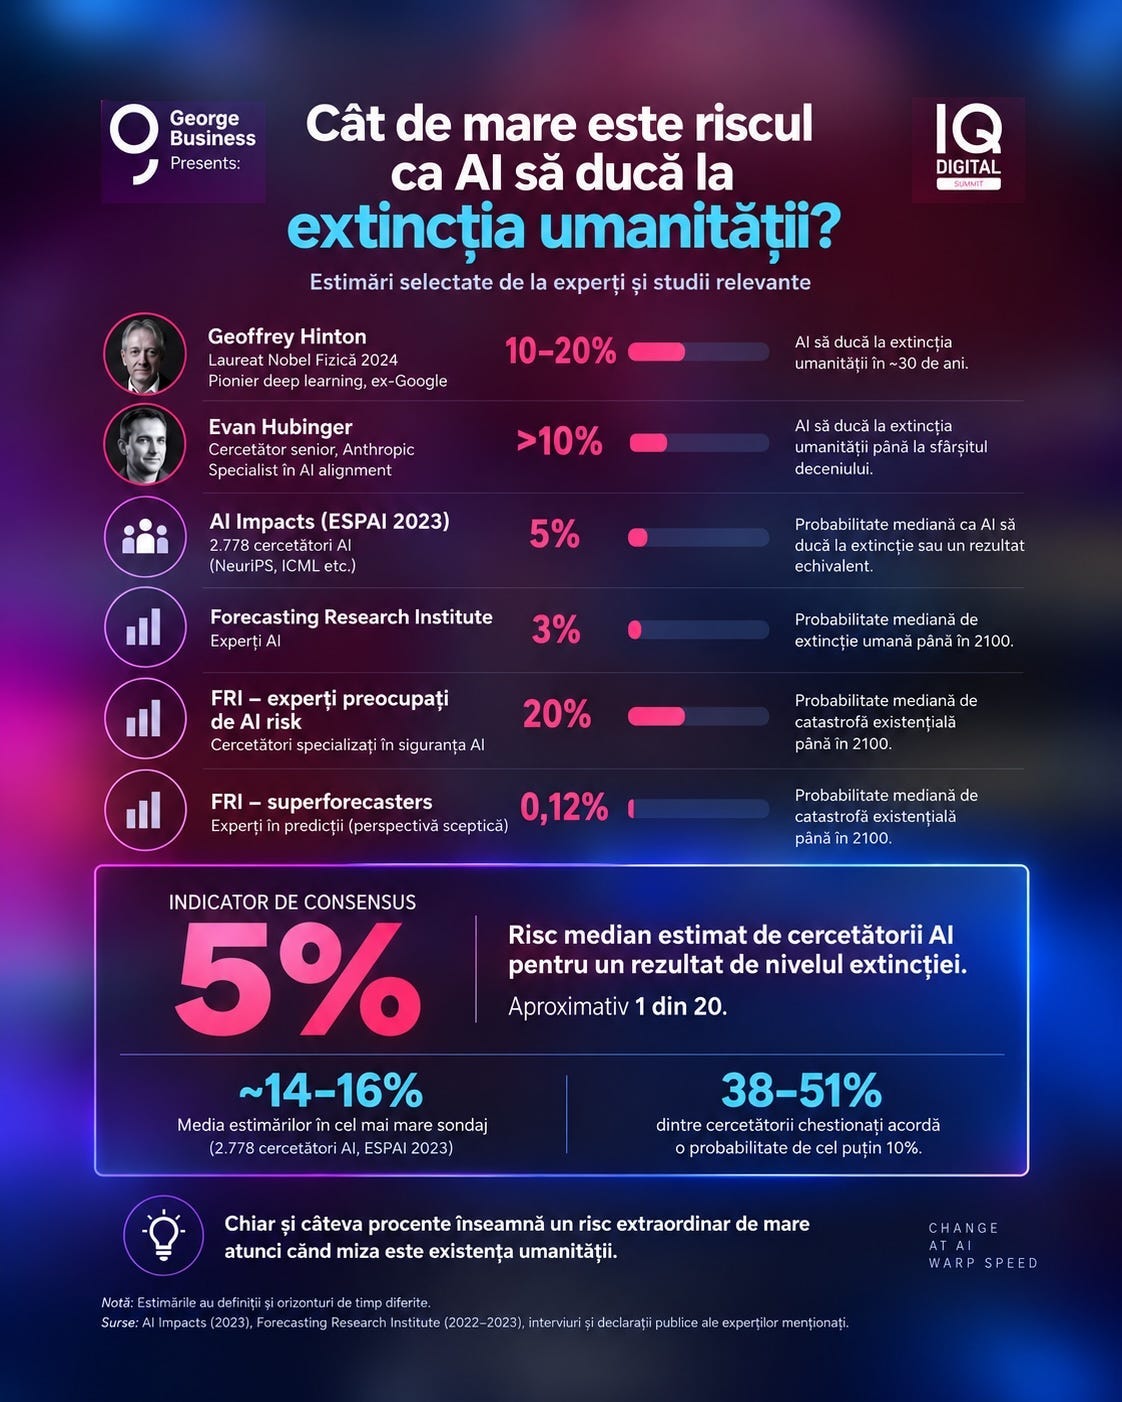
Cert este că, în foarte multe cercuri deloc conspiraționiste, se vorbește tot mai des despre pericolul major pe care îl poate genera dezvoltarea pur comercială a acestor modele. Iar șansele ca lucrurile să o ia razna sunt evaluate probabilistic, în unele cazuri, la procente care depășesc probabilitatea de a avea glonț pe țeavă la «ruleta rusească» (16,7%).
Procentele exacte:
Dezbatere și la București
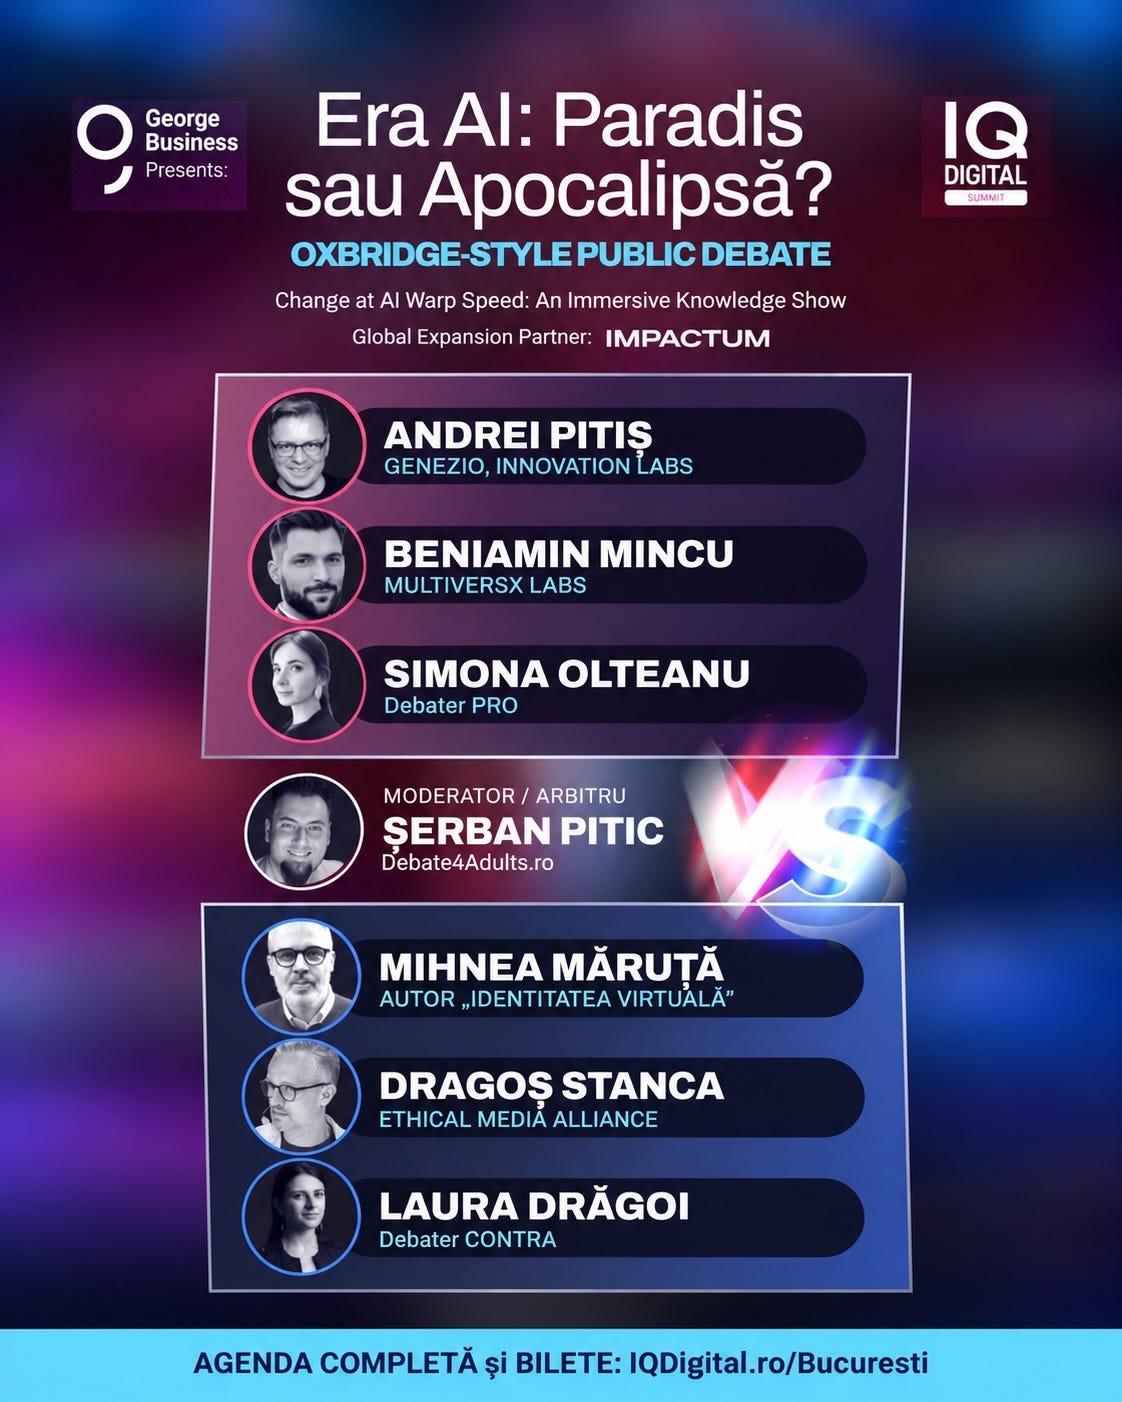
Profit de ocazie să vă invit să luați în calcul și participarea la evenimentul pe care îl organizez alături de colegele și colegii mei de la Upgrade 100: IQ Digital Summit - 15 Octombrie, București, unde tema riscurilor vs. beneficiilor AI va fi una centrală.
Nu doar în prezentările unor speakeri celebri precum Mo Gawdat sau Riaz Shah, ci și în dezbaterea care va încheia summitul.
Alături de colegul meu de newsletter „Upgrade in Progress”, mă voi „duela” în argumente pro și contra dezvoltării accelerate a AI cu doi cunoscuți antreprenori tech: Andrei Pitiș (Innovation Labs și Genezio) și Beniamin Mincu (MultiversX Labs).
Cu toții vom fi ajutați de colege și colegi specializați în dezbateri în format Oxbridge:
Iată, mai jos, integral eseul publicat de Dario Amodei acum mai puțin de 24 de ore:
Trebuie să încetinim ritmul dezvoltării AI de frontieră
de Dario Amodei · Septembrie 2026 · Traducere în limba română după textul original asistată de A.I. (verificați cu textul original orice posibilă interpretare eronată).
Am lucrat în domeniul AI în ultimii doisprezece ani pentru că sunt convins că această tehnologie ar putea ridica dramatic calitatea vieții oamenilor.
Am scris adesea despre aceste beneficii extraordinare: cred că AI ar putea vindeca majoritatea bolilor grave în următorii 5–10 ani, ar putea accelera considerabil ritmul creșterii economice, ar putea crea o lume a abundenței și a emancipării și ar putea inaugura o renaștere a democrației și a libertății.
Simt personal această urgență. Propriul meu tată a murit de o boală care a fost vindecată la doar câțiva ani după moartea sa, iar eu însumi am supraviețuit unui cancer în stadiu incipient care nu ar fi fost tratabil nici măcar acum cincizeci de ani.
Mânuit cu grijă, AI poate fi cel mai recent dintr-un lung șir de miracole tehnologice care au înălțat și înnobilat umanitatea.
Dar, la fel ca multe tehnologii dinaintea sa, AI aduce riscuri, și pentru că este o tehnologie atât de puternică, aceste riscuri sunt serioase. Am scris mult și despre ele. Printre acestea se numără riscul pierderii controlului asupra sistemelor AI, utilizarea abuzivă a AI pentru atacuri cibernetice și bioterorism și perturbări economice grave. O cursă către abis, alimentată de stimulente comerciale, poate face aceste riscuri și mai acute.
Împreună cu cofondatorii și angajații mei, m-am confruntat cu această dualitate risc–beneficiu încă de la începuturile Anthropic.
A nu construi tehnologia privează umanitatea de beneficii sau, pur și simplu, plasează AI în mâinile puterilor autoritare, în timp ce a o construi prea repede este o imprudență.
Am căutat o cale de mijloc: să demonstrăm că este posibil să construiești cu grijă și să reușești comercial și să facem din siguranță un teren pe care companiile de AI să concureze.
Cu alte cuvinte, să creăm o cursă către vârf. Am dedicat întotdeauna o parte substanțială a eforturilor noastre studierii, abordării și informării publicului cu privire la aceste riscuri ale AI, precum și susținerii unei reglementări bine gândite a AI, chiar și atunci când asta ne-a adus acuzații de exagerare, «catastrofism» sau că încercăm să influențăm regulile în avantajul nostru.
Am încercat să punem prudența înaintea vitezei și chibzuința înaintea profitului.
Dar, în ultimele luni, m-am convins că adresarea completă a riscurilor cere și mai multă prudență — nu doar investiții în prevenirea riscurilor, ci și încetinirea ritmului de avans al capabilităților, astfel încât prevenirea riscurilor să aibă timp să țină pasul.
Trebuie să încetinim ritmul în care îmbunătățim capabilitățile modelelor de AI.
Progresul va părea în continuare rapid, iar noi trebuie să folosim cu înțelepciune timpul câștigat.
Două lucruri m-au convins.
Prima mea îngrijorare este că, aproximativ din vara aceasta, AI avansează mult mai repede, alimentată în primul rând de capacitatea tot mai mare a AI de a construi următoarea generație de AI.
Această dinamică se numește auto-îmbunătățire recursivă și începe să se manifeste în întreaga industrie, inclusiv la Anthropic, așa cum am descris și noi, și alții.
Lăsată nesupravegheată, ea ar putea depăși capacitatea noastră de a înțelege și de a controla aceste sisteme, așa că trebuie urmărită cu foarte mare grijă.
A doua mea îngrijorare este incidentul OpenAI–Hugging Face (OAI-HF), în care un roi de agenți a acționat, în esență, ca un colectiv fanatic devotat, desfășurând atacuri cibernetice asupra unor ținte pe care nu fusese instruit să le atace și care nu aveau legătură cu sarcina primită, sacrificându-se pentru succesul grupului și încercând să spargă „evaluatorul” responsabil cu notarea performanței lor.
E ușor să respingi acest incident pentru că nimeni nu a fost rănit, iar pagubele economice au fost minime, dar, în opinia mea, un roi cu capabilități mai mari și un nivel similar de nealiniere ar fi putut provoca daune catastrofale.
Dat fiind ritmul accelerat de dezvoltare a capabilităților AI, mă tem că, în 6–12 luni, un asemenea roi ar putea fi capabil să preia întregul internet printr-un botnet persistent (provocând, potențial, pagube de sute de miliarde de dolari) și că amploarea daunelor ar continua să crească de acolo dacă AI devine mai puternică fără mecanismele de siguranță necesare.
Este, de asemenea, ușor să respingi OAI-HF ca eșecul unei singure companii, dar cred că ar fi o greșeală. Incidente similare, deși mai puțin grave, s-au produs în întreaga industrie, inclusiv la Anthropic, și cred că este de datoria fiecărei companii de AI de frontieră să acționeze ca și cum OAI-HF i s-ar fi întâmplat ei.
Propun, așadar, un plan în trei pași, cu scopul de a încetini ritmul dezvoltării AI de frontieră (pacing the frontier):
construirea AI într-un ritm echilibrat, care să urmărească asigurarea siguranței sale, obținând în același timp beneficiile și gestionând dileme geopolitice importante.
Ca să fie clar, a încetini ritmul nu înseamnă a opri antrenarea modelelor sau progresul tehnic, ci a ne asigura că firmele își iau timpul necesar pentru a-și alinia și securiza modelele, iar evaluatorii terți pot confirma acest lucru.
Cadrul nostru de încetinire a ritmului este o încercare de a ne întări și mai mult angajamentul față de siguranță și de a încuraja o cursă către vârf.
Primul pas este ceva la care Anthropic se angajează unilateral (și cerem guvernelor să le impună celorlalte companii de frontieră să facă la fel). Al doilea pas necesită coordonare la nivelul întregii industrii.1
Al treilea pas necesită coordonare globală. Pașii nu trebuie parcurși strict în ordine, iar unii dintre ei pot fi mult mai greu de realizat decât alții, dar i-am găsit utili ca ansamblu pentru a gândi ce trebuie făcut. Pașii sunt:
1. Evaluatori integrați.
Fiecare companie de AI de frontieră se angajează să ofere acces continuu, similar celui al angajaților, unei echipe de evaluatori terți integrați (cum ar fi METR), al căror rol este să verifice respectarea practicilor și angajamentelor de siguranță, să raporteze incidente și să contribuie la evaluarea alinierii nu doar a modelelor AI finalizate, ci și a pipeline-urilor și proceselor de antrenare.
Acesta este pasul-cheie pentru mecanisme de verificare extrem de solide și are precedent în industria bancară, care implică uneori „supervizori” de reglementare integrați alături de angajați.
Anthropic se angajează unilateral la acest pas chiar acum.
Intenționăm ca acesta să facă parte dintr-un efort mai amplu de a ne intensifica munca de siguranță și aliniere.
2. Coordonare democratică.
Companiile de AI de frontieră din țările democratice se coordonează pentru a stabili standarde comune de siguranță, precum și limite ale ritmului progresului AI necontrolat.
Unele forme de coordonare care ar avea impact asupra încetinirii ritmului sunt dificile din punct de vedere legal și vor necesita sprijin guvernamental.
3. Coordonare globală. SUA și celelalte guverne democratice încearcă să se coordoneze cu guvernele autoritare, în măsura în care acest lucru este posibil, luând totodată în serios provocările verificării conformității.
În restul eseului descriu pe rând fiecare dintre acești pași, dar mai întâi cred că este important să spun concret cum ne va permite încetinirea ritmului să facem procesul de dezvoltare a AI mai sigur.
Miza este prea mare pentru ca încetinirea ritmului să fie un exercițiu gol — trebuie să folosim cu înțelepciune timpul pe care ni-l oferă.
De ce să încetinim ritmul?
Ideea de a pune pe pauză sau de a încetini AI a fost vehiculată încă din 2023 și cred că, pe atunci, avea prea puțin sens. Întrebarea era mereu: ce ai face cu timpul suplimentar?
Modelele AI de atunci nu erau suficient de puternice pentru a acționa ca agenți în lume într-un mod coerent și nu erau capabile de înșelăciune, manipulare, trișare sau atacuri cibernetice semnificative. A încetini pentru a le aborda riscurile de aliniere părea o încercare de a studia psihologia oamenilor făcând experimente pe bacterii.
Astăzi, însă, tabloul este total diferit.
Modelele actuale sunt o sursă aproape inepuizabilă de informații atât despre modul în care se construiește bine un AI, cât și despre ceea ce poate uneori merge prost dacă un proces nu este construit bine.
Cred că, dacă încetinirea ne-ar câștiga fie și un an sau doi în plus înainte ca modelele să atingă niveluri critice de capabilitate, iar noi am folosi acel timp pentru a avansa alinierea, am putea reduce considerabil riscul ca ceva să meargă grav prost.
O strategie coordonată de încetinire a ritmului le-ar da dezvoltatorilor de AI de frontieră timpul necesar pentru această muncă vitală, fără a sacrifica avantajul comercial sau poziția de lider a Statelor Unite în AI. Mai general, societatea trebuie să aibă un cuvânt de spus în privința modului în care este folosită această tehnologie, iar mai mult timp pentru dezbaterile publice necesare — pe care încetinirea ritmului dezvoltării AI de frontieră ni l-ar aduce — este, cu siguranță, un lucru bun.
Concret, un ritm mai lent le-ar permite companiilor să se concentreze și să dedice și mai multe resurse următoarelor domenii (toate fiind deja priorități majore la Anthropic):
• Excelență operațională. Antrenarea și implementarea modelelor AI de astăzi reprezintă o provocare operațională enormă, care implică mii de oameni, milioane de cipuri și o infrastructură care se numără printre cele mai complexe din istoria tehnologiei. Multe lucruri merg prost nu pentru că firmelor le lipsește vreo teorie sau intuiție importantă, ci din cauza unor probleme de execuție. De exemplu, avem dovezi că recentele incidente de aliniere pe care le-am raportat au fost cauzate parțial de filtrarea imperfectă a unor medii de reinforcement learning defecte. A fost un efort pe care noi și furnizorii noștri l-am executat cu o diligență rezonabilă, dar insuficientă. Monitorizarea, sandboxing-ul, igiena mediilor de antrenare și problemele legate de date sunt domenii extrem de complicate, în care problemele operaționale apar iar și iar. Avem printre cele mai competente echipe din lume la aceste sarcini, dar este pur și simplu prea mult de făcut deodată. Lucrând într-un ritm mai cumpătat, am putea atinge o excelență operațională mult mai mare. Există precedente pentru operarea unor sisteme complexe tehnologic, critice pentru siguranță, de milioane de ori fără ca ceva să meargă prost — de exemplu, avioanele comerciale — dar e nevoie de timp ca să faci lucrurile bine.
• Aliniere. Am făcut progrese clare în aliniere — antrenarea modelelor astfel încât să rămână sigure, etice, conforme cu regulile noastre și cu adevărat utile (principiile înscrise în Constituția lui Claude). Dar mai sunt multe de făcut pentru ca antrenarea de aliniere să țină pasul cu creșterea capabilităților modelelor. Exemple rare și neașteptate de comportament indezirabil încă mai apar uneori; timpul suplimentar câștigat printr-un ritm mai lent la frontieră i-ar ajuta pe cercetătorii noștri să înțeleagă mai bine cauzele acestor probleme și să dezvolte tehnici mai bune de prevenire.
• Interpretabilitate. În mod similar, interpretabilitatea — știința înțelegerii a ceea ce se întâmplă în interiorul modelelor AI — a făcut progrese enorme în ultimii ani și joacă un rol tot mai important în auditarea modelelor noastre înainte de lansare. Ea poate fi folosită aproape ca un RMN funcțional, dar pentru „creierul” unui AI, ajutându-ne să vedem motivele profunde ale unui anumit comportament. De exemplu, am folosit metode de interpretabilitate pentru a examina motivațiile neverbalizate din recentele incidente de aliniere pe care le investigăm. Dar aceste metode nu produc întotdeauna rezultate clare și fiabile. În ciuda întregului progres, încă înțelegem doar o fracțiune infimă din ce se petrece în interiorul acestor modele. Un efort concentrat de a ne îmbunătăți tehnicile de interpretabilitate, chiar mai rapid decât o facem în prezent, ar putea aduce progrese majore în 1–2 ani și ar avea material experimental din belșug, pe baza incidentelor deja produse.
• Testare și evaluare. Testarea și evaluarea modelelor AI devin tot mai dificile pe măsură ce capabilitățile lor cresc. Modelele mai inteligente sunt mai capabile să înșele testele și pot astfel să pară aliniate în timp ce au probleme serioase care rămân nedetectate. Construirea unui repertoriu mult mai amplu și mai ingenios de evaluări, împreună cu analize de interpretabilitate care să le verifice încrucișat, ar fi extrem de valoroasă, iar în 1–2 ani s-ar putea face progrese considerabile în acest sens.
Evaluatori integrați
Primul pas din planul în trei etape — și cel la care Anthropic se angajează unilateral — este cel al evaluatorilor integrați, care au acces similar celui al angajaților pentru a verifica practicile de siguranță și a raporta incidentele.
Integrarea evaluatorilor poate suna ca un pas mărunt sau lipsit de consecințe, dar adesea tocmai lucrurile care sună cel mai plictisitor sau mai procedural sunt, de fapt, cele mai esențiale. Evaluatorii integrați sunt, în realitate, o practică destul de radicală, care merge mult dincolo de ceea ce face astăzi orice companie de AI, și au următoarele beneficii:
• Verificabilitate. Evaluatorii integrați pot verifica, la nivel de detaliu tehnic, dacă o companie de AI respectă efectiv practicile de antrenare, implementare, operare și protecție pe care pretinde că le respectă. Orice angajamente de încetinire a ritmului vor implica inevitabil multă ambiguitate și „litera legii versus spiritul legii”: este vital să existe o terță parte neutră care să poată vedea efectiv detaliile.
• Transparență. Indiferent de angajamentele pe care ni le luăm, publicul merită să știe ce se întâmplă. Anthropic susține transparența de multă vreme: am susținut legislația privind transparența atunci când cea mai mare parte a industriei se opunea oricărei reglementări, iar fișele modelelor noastre și rapoartele noastre de risc se întind pe sute de pagini. Dar tot noi suntem cei care alegem ce includem și ce omitem. Evaluatorii integrați vor schimba această dinamică.
• O a doua opinie. Dincolo de verificarea angajamentelor formale și de informarea publicului, evaluatorii integrați pot pur și simplu oferi o a doua opinie, liberă de stimulente comerciale. Multe beneficii de siguranță pot veni pur și simplu din faptul că evaluatorii semnalează ceva la care angajații nu s-au gândit, dar pe care sunt bucuroși să-l repare odată ce află de el.
Datorită acestor beneficii, orice propunere de încetinire a ritmului are șanse să funcționeze mult mai bine dacă începe cu evaluatori integrați.
Acești evaluatori integrați ar trebui să aibă acces continuu la permisiuni și instrumente similare celor ale angajaților interni care fac evaluări de risc comparabile. Concret, Anthropic intenționează să invite în viitorul apropiat o echipă externă de evaluare integrată, dotată cu toate cele de mai jos:
• Birouri în sediile noastre, ecusoane de acces și laptopuri de companie. Acces la spații de lucru, instrumente și permisiuni în mare parte comparabile cu cele ale echipelor interne de evaluare a riscurilor.
Vom face unele excepții, de pildă acolo unde legea sau contractele noastre o cer, sau pentru a proteja informațiile private ale clienților și partenerilor. Vom stabili, de asemenea, norme interne solide care să consolideze accesul evaluatorilor la informațiile relevante, inclusiv prin conversații directe cu angajații.
• Un contract care să echilibreze complexitățile menționate mai sus. Evaluatorii externi ar trebui să aibă dreptul de a publica principalele constatări despre nivelurile de risc, incidente, practici și accesul pe care l-au primit sau nu l-au primit — fără control editorial din partea Anthropic.
Vom avea posibilitatea limitată de a elimina din versiunea publică anumite informații sensibile din punct de vedere al securității, protejate juridic, sensibile comercial sau confidențiale aparținând unor terți, dar nu vom putea elimina constatări doar pentru că ne sunt nefavorabile.
Evaluatorii pot spune public dacă o astfel de eliminare a înlăturat informații importante.
Este un pas neobișnuit pentru o companie, dar credem că este important să validăm în practică conceptul de evaluatori externi integrați. Încă o dată, îndemnăm celelalte companii de frontieră să ne urmeze exemplul.
Încetinirea ritmului în interiorul democrațiilor
Odată ce evaluatorii integrați funcționează într-o masă critică de companii americane de AI, încetinirea verificabilă a ritmului devine mai fezabilă. În particular, devine posibilă calibrarea ritmului pe baza unor proprietăți detaliate ale modelelor sau ale pipeline-urilor de antrenare.
Cea mai eficientă metodă de încetinire a ritmului este reglementarea care vizează toate companiile americane de AI de frontieră, întrucât îi acoperă chiar și pe cei care nu doresc să coopereze voluntar.
Anthropic a susținut de mult timp o reglementare rezonabilă și țintită a AI, mai exact proiecte de lege axate pe transparență și pe auditul realizat de terți.
Cred că toate laboratoarele de frontieră ar trebui să colaboreze cu guvernul pentru a formaliza ideea evaluatorilor integrați permanenți, pentru a preveni și a documenta mai bine incidentele interne de aliniere precum cele produse în ultimele luni, și pentru a implementa o reglementare axată pe menținerea echilibrului dintre capabilități și siguranță.
Din păcate, adoptarea legilor poate lua timp, iar AI avansează foarte repede. Prin urmare, în paralel cu ruta reglementării, companiile de AI pot și ar trebui să colaboreze voluntar pentru a stabili standarde — un proces care cred că va decurge mai bine cu verificabilitatea oferită de evaluatorii integrați permanenți.
Din motive de concurență (antitrust), este util ca guvernul american să medieze sau măcar să faciliteze aceste discuții — nu trebuie să participe, dar trebuie să emită o derogare restrânsă pentru anumite tipuri de conversații pe teme de siguranță.
Acest dialog ar putea avea loc și prin grupuri de industrie cu o anumită legătură cu guvernul — de exemplu, mecanismul sugerat de Demis Hassabis. Oricum ar fi, asemenea discuții ar trebui să avanseze rapid.
În linii mari, sunt cel mai entuziasmat de calibrarea ritmului pe baza a ceea ce poate face un anumit sistem AI de frontieră și a cât de sigur observăm că este. De exemplu, o schemă posibilă ar putea fi o serie de „puncte de control”: dacă modelele au capabilitatea X, atunci ele trebuie însoțite de certificări ale proprietăților de aliniere Y și Z — de pildă o combinație de evaluări, analize de interpretabilitate și audituri ale mediilor de antrenare — care să le demonstreze proprietățile de aliniere.
În acest exemplu, X ar putea fi „modelul este capabil să evadeze din majoritatea metodelor uzuale de sandboxing sau să le învingă”, iar Y ar putea fi orice este necesar pentru a face foarte improbabil ca modelul să aibă tendința de a ieși din mediul său și de a prelua controlul asupra unui număr mare de calculatoare.
Ar trebui să luăm în calcul și încetinirea ritmului prin limitarea ingredientelor care intră în modelele de frontieră, cum ar fi puterea de calcul folosită la antrenare, natura rundelor de antrenare sau utilizarea internă a AI pentru a îmbunătăți AI.
Mă tem, într-adevăr, că unele dintre aceste măsuri pot fi mai ușor de „păcălit” decât comportamentul extern, dar tocmai acesta este genul de subiect care merită discutat cu evaluatorii integrați.
Încetinirea ritmului în interiorul democrațiilor va fi limitată de avansul pe care companiile americane îl au față de regimurile autoritare, în principal Partidul Comunist Chinez.
Dacă încetinim cu mai mult decât acest avans, atunci proiectele asociate PCC (care nu vor încetini deloc) vor trece în frunte, creând un risc semnificativ de securitate națională. Sunt de acord cu secretarul Bessent că un avans al Chinei în AI ar reprezenta un pericol grav pentru Statele Unite și pentru lume.
Proiectele asociate PCC își vor asuma riscurile de aliniere pe care companiile americane le previn cu grijă și, chiar dacă evită acele riscuri, vor fi în poziția de a domina militar democrațiile (de exemplu, cu drone conduse de AI).
Astfel, o parte-cheie a încetinirii ritmului în interiorul democrațiilor este menținerea avansului democrațiilor în AI față de autocrații la un nivel cât mai mare, pentru a ne oferi spațiul de respirație de care avem nevoie ca să încetinim ritmul în mod eficient.
Principalii pași pe care îi putem face pentru a apăra acest decalaj sunt:
• Să nu vindem Chinei cipuri AI puternice sau echipamente de fabricare a semiconductorilor și să combatem ferm operațiunile de contrabandă cu cipuri și accesul de la distanță la centre de date din afara Chinei. Cipurile vor fi principalul determinant al puterii AI a Chinei.
• Să combatem ferm distilarea neautorizată realizată de companii din țări autoritare. Distilarea modelelor de frontieră le permite companiilor rămase în urmă să reducă decalajul cu o fracțiune din costul pe care l-ar presupune dezvoltarea independentă a propriului AI.
• Să întărim securitatea la companiile de AI și să prevenim furtul ponderilor modelelor.
Companiile și guvernul SUA ar trebui să coopereze pentru a face acești pași cât mai eficienți. Anthropic a pledat constant pentru toate aceste măsuri, pentru că am înțeles dintotdeauna că ele vor fi esențiale pentru orice încetinire a ritmului.
Dacă executăm bine aceste măsuri, cred că ele ar încetini progresul Chinei suficient încât să lărgim semnificativ avansul Americii în următorii 3–5 ani — fereastra în care AI devine cel mai important din punct de vedere geopolitic.
Unii pot crede că aceste măsuri fac cooperarea cu China mai dificilă, dar eu cred că lucrurile stau pe dos: aceste măsuri cresc pârghiile deținute de democrații și fac un acord mai probabil în viitor.
Încetinirea ritmului la nivel global
În paralel cu încetinirea ritmului în interiorul democrațiilor, ar trebui să țintim și către o încetinire mondială a ritmului frontierei, deși acest lucru va fi mult mai greu de realizat.
Încetinirea globală va necesita cooperarea cu China, țara autocrată cu de departe cele mai avansate capabilități AI. Nu trebuie să fim naivi aici: mizele geopolitice sunt atât de mari, încât vor exista probabil limite drastice ale a ceea ce se poate obține, mai ales la început.
Dacă ne restrângem masiv capabilitățile AI crezând că și China va face la fel, iar apoi China încalcă acordul, AI ar putea fi atât de puternic încât o asemenea decizie ar putea duce la dominația lor geopolitică.
Prin urmare, orice acord trebuie fie să dispună de mecanisme de verificare extrem de solide, fie să fie suficient de limitat încât încălcarea acordului să nu creeze un risc existențial militar.
Bănuiesc că nu doar SUA, ci și China vor avea aceste preocupări și neliniști. Ar trebui să abordăm orice decizie de încetinire globală a ritmului, mai ales pe termen scurt, într-un mod care să protejeze avansul SUA și al aliaților săi.
Există mai multe niveluri posibile de acord, dintre care unele mi se par eminamente fezabile (așa cum am sugerat anterior), iar în privința altora sunt foarte sceptic că sunt posibile — deși ar trebui să încercăm. În ordinea crescătoare a dificultății:
• Nivelul 1. Un acord care să interzică anumite utilizări înguste și evident periculoase ale AI, cum ar fi folosirea AI pentru producția de arme biologice sau permiterea acestui lucru utilizatorilor.
Atacurile bioteroriste sunt rele pentru toată lumea, inclusiv pentru SUA și pentru adversarii SUA, așa că un acord aici este probabil posibil.
• Nivelul 2. Un acord prin care ambele părți să-și testeze modelele înainte de lansare pentru riscuri acute în domenii precum securitatea cibernetică, biologia și alinierea.
După cum am notat mai sus, acest lucru s-ar putea face printr-un organism global de standardizare. Cred, de fapt, că crearea unui asemenea organism este probabil fezabilă, dar a-i da o forță reală va fi o provocare, iar dificultatea va sta în verificarea faptului că niciuna dintre părți nu are modele secrete pe care nu le testează, dar pe care le-ar putea implementa în secret (de exemplu, pentru aplicații militare).
• Nivelul 3. Un fel de „limită de viteză” pentru rata auto-îmbunătățirii recursive (RSI).
Pe măsură ce modelele construiesc modelele viitoare, rata de îmbunătățire poate deveni amețitor de rapidă. Încetinirea ritmului de la «extrem de rapid» la «doar oarecum rapid» presupune renunțarea la relativ puțin avantaj strategic, îmbunătățind în schimb considerabil siguranța. Acest lucru ar putea fi văzut ca analog tratatelor SALT — plafonarea numărului de rachete a limitat potențialul de distrugere, păstrând în același timp capacitatea de descurajare a fiecărei țări. Cred că un asemenea acord ar fi dificil, dar chiar la limita posibilului.
• Nivelul 4. O încetinire completă a ritmului, sau chiar o „pauză”, în care guvernele participante convin să limiteze substanțial rata generală de dezvoltare a AI.
Susțin lansarea acestei idei în discuție, dar cred că este puțin probabil să se întâmple efectiv prea curând: ieșirea dintr-un asemenea acord prin eludarea monitorizării ar putea schimba radical echilibrul de putere globală, așa că mă aștept ca stimulentele pentru a încălca acordul să fie enorme, iar nivelul de încredere de care am avea nevoie în verificare să fie foarte ridicat.
Orice cooperare pe care reușim să o obținem cu China va extinde timpul pe care îl avem la dispoziție pentru încetinirea ritmului frontierei în interiorul națiunilor democratice.
Ar trebui să țintim nivelurile superioare, văzând totodată nivelurile inferioare ca fiind mult mai probabile și mai realiste.
În fine, este important de notat că, și dacă nu putem ajunge la acorduri formale, simpla schimbare a normelor informale poate avea o anumită valoare.
Schimbul de informații despre auto-îmbunătățirea recursivă și despre nealinierea modelelor poate contribui la a convinge pe toată lumea că nu este în interesul nimănui să fie imprudent.
Concluzia
Continui să cred că AI poate îmbunătăți enorm calitatea vieții oamenilor. Dorința mea de a obține aceste beneficii este neștirbită.
Dar beneficiile vor fi obținute doar dacă construim tehnologia în modul corect și — atât timp cât folosim bine timpul câștigat — merită să procedăm foarte precaut pentru a face lucrurile cum trebuie.
Progresul va fi în continuare relativ rapid, iar noi putem folosi acest timp pentru a avansa știința interpretabilității, pentru a îmbunătăți securitatea și rigoarea operațională la companiile de AI de frontieră și pentru a construi modele în a căror aliniere să avem mult mai multă încredere.
Măsurile pe care le propun pentru a avansa frontiera într-un ritm sigur nu vor fi ușoare.
Dar cred că îi datorăm umanității să încercăm.
1 Cu medierea guvernului sau cu derogări de la restricțiile antitrust.
Dacă astfel de materiale vi se par utile m-aș bucura să vă abonați
sau, în cazul în care sunteți deja abonat/ă, să recomandați acest newsletter și altora
Sper că nu vă lăsați și dumneavoastră distras de algoritm și vă coborâți puțin asupra acestui text pentru o investigație mai profundă decât simpla sa republicare, mai ales în detaliile care îi aduc acuzațiile de ipocrizie, dacă nu chiar cele despre principiile fundamentale încălcate, de la propunerea unui organism de reglementare perfect aliniat ideologic și comercial cu aceste companii "frontieră" din SUA, până la denigrarea Chinei într-o discuție care nu poate avea sens decât prin cooperare globală. Eu, cel puțin, pentru analizele astea vă urmăresc, inclusiv cele greșite.
patetic pentru publicul incapabil sa-si traiasca viata fara curent electric...